 Simone
NCBI BLAST使用教程及BLASTP比对结果分析
的有关信息介绍如下:BLAST(Basic Local Alignment Search Tool)是由美国国立生物技术信息中心(NCBI)开发的一个基于序列相似性的数据库搜索程序。该程序能够将核酸/蛋白质序列与公开数据库中的所有序列进行匹配比对,从而找到相似序列。BLAST有在线和单机版两种形式,用户可以根据需求选择使用。
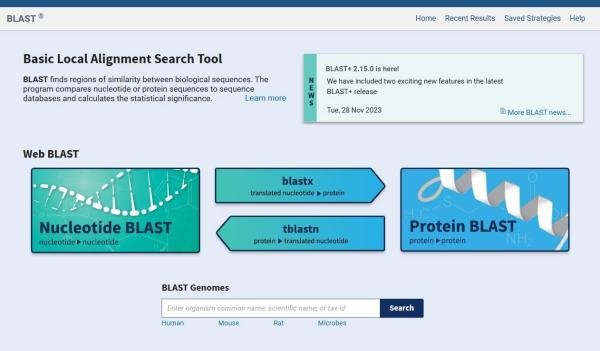
一、访问BLAST界面
二、BLASTP检索
BLASTP是用于蛋白质序列比对的工具。以下是进行BLASTP检索的步骤:
基本检索
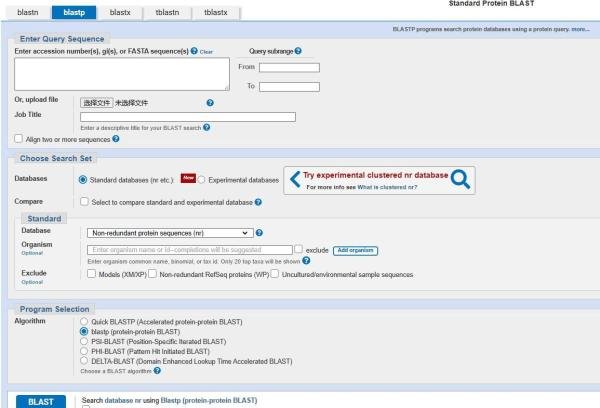
输入查询序列:在“Enter query sequence”框中输入要查询的蛋白质序列。
选择搜索数据库:在“Choose search set”中选择要搜索的数据库,一般选择nr(非冗余蛋白质数据库)或swissprot等。
选择物种(可选):在“Organism”中选择特定物种以缩小搜索范围。
算法参数设置
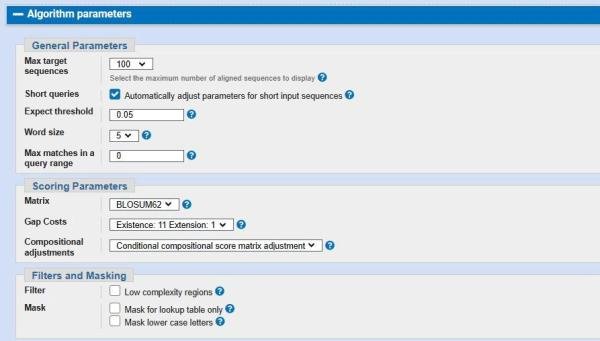
基本参数:
Max target sequence:设置要显示的最高匹配序列数,默认为100。
Short queries:对于短查询序列,可以调整此参数以影响期望值和字段长度。
Expected threshold:期望值E是一个重要的筛选指标,表示在数据库搜索中偶然发生的不同比对的个数。
Word size:单词长度,默认为3。对于BLASTP而言,较大的单词长度会得到更精确的搜索结果。
Max matches in a query range:允许抛弃数据库中的冗余匹配。
得分参数:
Matrix:选择氨基酸替换矩阵,默认使用BLOSUM62。对于短序列查询,建议使用PAM30矩阵。
Gap costs:设置空位成本,包括打开罚分和延伸罚分。
Compositional adjustment:进行组成校正,以适用于两个存在不标准组成的蛋白质之间的比对。
筛选和遮盖:
Filter:可以遮盖查询序列中的低复杂度部分。
Masking:对超过预期与数据库匹配的单词进行遮盖,避免匹配到低复杂度序列或重复片段。
三、检索结果
点击“BLAST”运行后,等待检索结果。检索结果将显示一系列与查询序列相似的蛋白质序列信息。
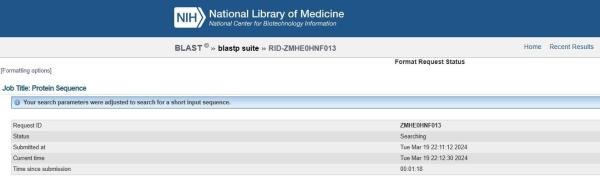
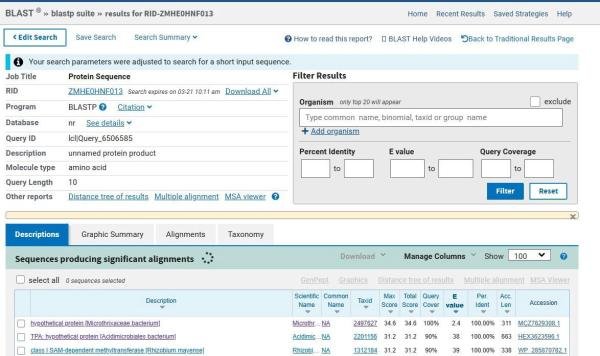
检索结果中包含了多个与查询序列相似的蛋白质序列信息,以下是对关键指标的解读:
Description:描述字段。如果结果中出现过多“hypothetical protein(假设蛋白)”、“Unnamed protein product(未命名蛋白)”、“Putative uncharacterized protein(未表征蛋白)”等结果,表明进行比对的数据库不太合适,检索结果意义不大。
Scientific Name:学名,表示匹配序列所属物种的科学名称。
Common Name:通用名,表示匹配序列所属物种的常用名称。
Taxid:物种的信息合集,表示匹配序列所属物种的税务分类标识符。
Max Score:最高得分,表示匹配序列与查询序列之间的最高相似性得分。分值越高,两个序列的相似性越高。
Total Score:总分,表示匹配序列与查询序列之间所有匹配片段的累计得分。
Query Cover:查询覆盖度,表示匹配序列覆盖查询序列的比例。
E value:E值,是一个统计值,表示匹配序列与查询序列之间偶然发生的概率。E值越小,匹配结果越可信。
Per. ident:一致性百分比,表示匹配序列与查询序列之间相同氨基酸的比例。
Acc. Len:序列长度,表示匹配序列的长度。
Accession:序列登录号,表示匹配序列在数据库中的唯一标识符。